

告别手工扒数据!2026 年现代网页采集神器选型全景:从传统爬虫到 LLM 原生抓取
在 Web 2.0 时代,写爬虫的核心工作是“解析 DOM”:从纷繁复杂的 HTML 结构中编写精确的 XPath 或 CSS 选择器,提取对应字段存入数据库。然而步入大模型与复杂单页应用(SPA)时代,前端工程的演进与反爬机制的剧烈对抗,让传统爬虫的维护成本呈指数级攀升。
一方面,现代网页充斥着 React/Vue 动态水合、无限滚动、Shadow DOM 与反爬盾牌(如 Cloudflare Turnstile、DataDome、Akamai 等);另一方面,大模型时代对数据采集的需求发生了质变——开发者不再仅仅需要离散的表格字段,而是需要去除了广告与噪音的、保留排版语义的 LLM-Ready Markdown 与结构化 JSON,以直接投喂给 RAG(检索增强生成)系统或自主智能体(AI Agent)。
面对五花八门的开源工具,开发者往往陷入选型困惑:究竟何时该用老牌稳定的 Scrapy,何时该用微软 Playwright,何时又该直接拥抱火爆的 Crawl4AI 或 Firecrawl?本文将结合 2026 年开源社区最新的实战演进,梳理出 10 款最具代表性的现代网页数据采集开源神器,并为你绘制一张清晰的架构演进与选型全景图。
一、 现代网页采集的技术演进与四层架构
如果将数据采集从“原始网络请求”到“高质量数据交付”的全流程拆解,现代网页采集系统已经演化出了清晰的四层流水线架构:
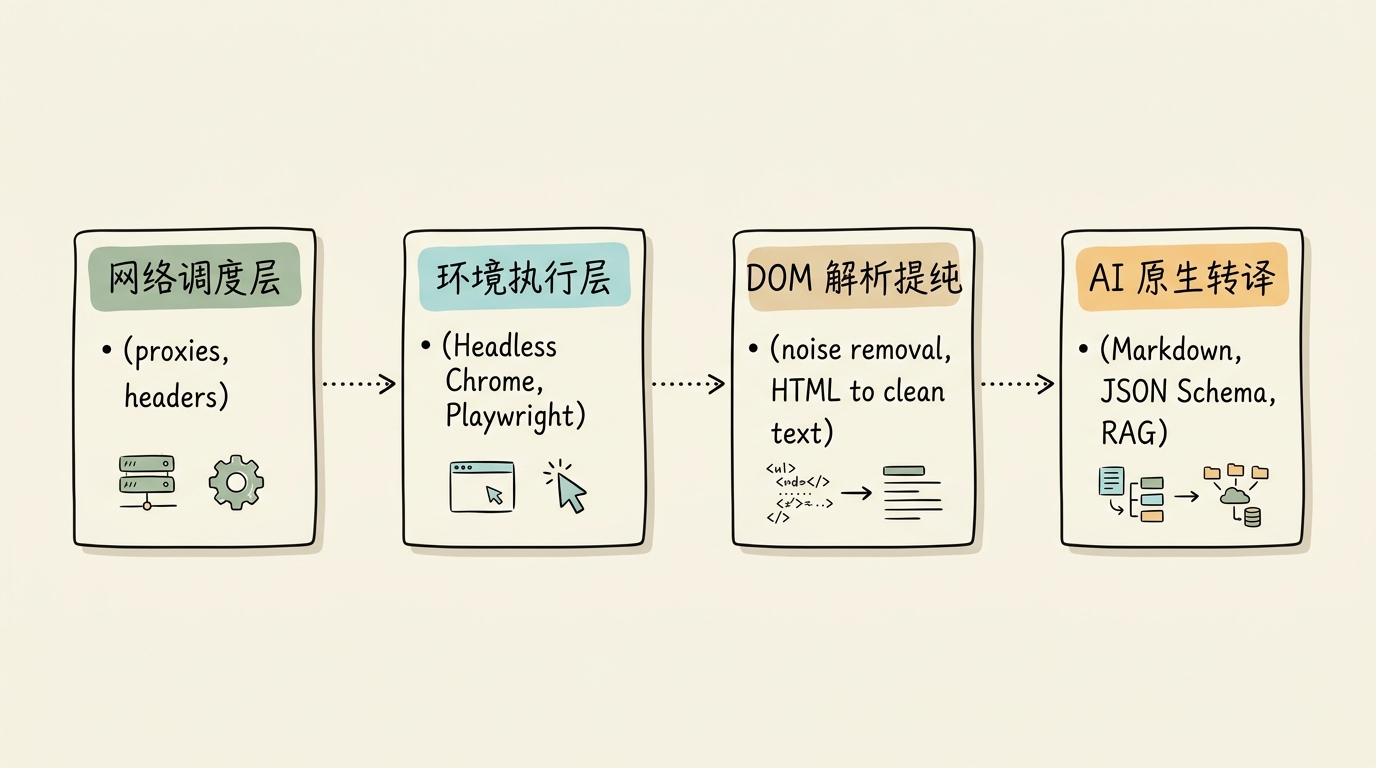
1. 网络调度层(Network Dispatch)
负责高并发网络连接、IP 代理池轮换、HTTP/2 及 HTTP/3 协商,以及最核心的 TLS 客户端指纹伪装(JA3/JA4 握手与 Header 顺序对齐)。在这一层,工具的核心诉求是“轻量、极速与抗风控封禁”。
2. 环境执行层(Browser & Runtime)
针对高度依赖客户端 JavaScript 渲染的富交互网站,单纯的 HTTP 请求只能拿到空白的 <div id="root"></div>。环境执行层通过无头浏览器(Headless Chromium/Firefox)完整模拟真实用户的操作链路,包括触发滚动加载、等待网络空闲、处理 LocalStorage 授权态与验证码交互。
3. DOM 解析与提纯层(Parsing & Noise Reduction)
这是现代爬虫与传统爬虫的一道重要分水岭。传统爬虫机械地提取标签,而现代数据采集必须自动过滤导航栏(nav)、页脚(footer)、弹窗、跟踪像素(tracking pixel)和侧边栏广告,保留文章主体与层次逻辑。
4. AI 原生转译层(LLM Ingestion & Semantic Structuring)
将提纯后的语义 HTML 转换为标准 Markdown、数学公式以及符合 JSON Schema 规范的结构化字典,让采集结果无需复杂的后续清洗即可直接注入大语言模型的 Context Window 或向量索引。
二、 10 大开源数据采集神器全景横评
结合 GitHub 社区关注度、技术栈完备度与实际生产落地反馈,我们将目前主流的 10 款开源采集工具划分为四大阵营,进行全维度横向对比:
| 序号 | 项目名称 | 核心语言 | 架构类型 | 动态 JS 渲染 | LLM/Markdown 原生 | 防爬对抗能力 | 最佳适用场景 |
|---|---|---|---|---|---|---|---|
| 1 | Crawl4AI | Python | AI 原生引擎 | 原生支持(Playwright 底座) | 原生极佳(自动转 Markdown/JSON) | ★★★★☆ | 大模型 RAG 知识库、AI Agent 数据源 |
| 2 | Firecrawl | TypeScript | AI 智能转译 API | 原生支持(全自动化) | 原生极佳(全站自动 Crawl & Map) | ★★★★☆ | 全站知识库抓取、自动化 API 转换 |
| 3 | ScrapeGraphAI | Python | LLM 驱动图管线 | 支持(Selenium/Playwright) | 自然语言零代码 Schema 抽取 | ★★★☆☆ | 网站结构经常改版、字段难以手工写选择器 |
| 4 | Playwright | Node/Py/Go | 浏览器自动化 | 原生完全支持 | 需配合插件(Turndown 等) | ★★★★★ | 复杂 SPA、滑块验证、强交互人工链路模拟 |
| 5 | Crawlee | TypeScript/Py | 生产级混合爬虫 | 支持(Cheerio/Playwright 混合) | 需二次封装 | ★★★★☆ | Node/TS 团队构建百万级工业爬虫管道 |
| 6 | Browser-Use | Python | Agent 浏览器接管 | 原生完全支持 | 基于多模态视觉与意图交互 | ★★★★★ | 需要登录、多步骤业务办理与自适应巡检 |
| 7 | Scrapy | Python | 经典分布式框架 | 需插件(Splash/Playwright) | 需编写自定义 Pipeline | ★★★☆☆ | 亿级纯静态网页采集、超高并发批处理 |
| 8 | Colly / Seimi | Go / Java | 极速高并发爬虫 | 较弱(需外部无头服务) | 需二次转换 | ★★☆☆☆ | 极致吞吐量需求、静态 API 接口扫描 |
| 9 | EasySpider (易爬) | C++ / Electron | 可视化无代码 RPA | 原生集成 Chrome 内核 | 支持导出结构化文件 | ★★★☆☆ | 业务运营人员、无需编码的快速取数需求 |
| 10 | WebRPA | Node.js | 可视化轻量自动化 | 支持本地 Chromium | 支持导出 Excel/CSV/JSON | ★★★☆☆ | 办公流程自动化、内网报表定时导出与比对 |
三、 四大核心阵营深度拆解与落地指南
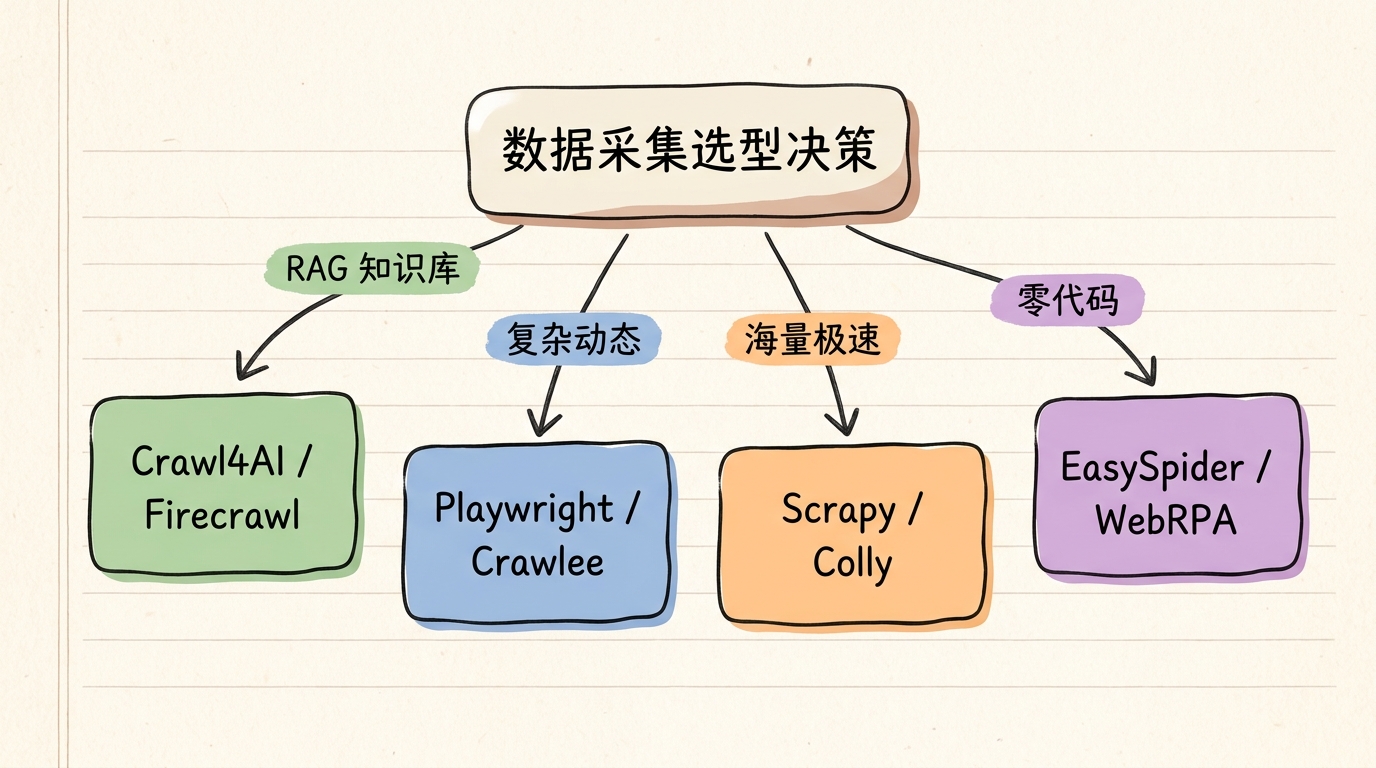
1. AI 原生与 LLM 数据采集阵营(Crawl4AI / Firecrawl / ScrapeGraphAI)
在大模型时代,这三款开源项目是真正的“当红炸子鸡”:
- Crawl4AI:GitHub 极速狂飙至 40k+ Stars 的明星项目。它专为大模型优化,底层深度整合了 Playwright,但通过优化的多进程异步事件循环,将单页面采集性能提升了 3-5 倍。更重要的是,它原生内建了基于语义启发式算法的文本提纯模块,能自动将网页转化成极其干净、保留标题树状结构的 Markdown,并支持依据 JSON Schema 进行免提示词字段提取。
- Firecrawl:能够将任意复杂的 Web 页面甚至整个子域名,通过单一入口一键“拍扁”为干净的 Markdown 列表,并自带智能站点地图(Sitemap)爬取模式,是构建企业私有知识库的首选基座。
- ScrapeGraphAI:彻底打破了“编写 CSS 选择器”的传统思想。你只需要给它一段自然语言指令(例如:“提取页面中的商品名称、价格和用户评分”),它会调用底层大语言模型自动生成管道图,并容忍前端类名随时发生的任意改版。
2. 现代无头浏览器与交互自动化阵营(Playwright / Crawlee / Browser-Use)
当面对单页复杂交互或必须带登录态的防爬页面时,无头浏览器是不可替代的基石:
- Playwright:微软出品的跨平台自动化王者。具备原生的自动等待(Auto-waiting)、网络请求拦截与修改、多上下文隔离(BrowserContext)以及强大的录制调试工具。对于现代异步加载的单页应用,Playwright 的稳定性和排错体验大幅优于老旧的 Selenium。
- Crawlee:来自 Apify 团队的工业级爬虫框架,完美结合了“静态抓取的极致性能(CheerioCrawler)”与“动态渲染的完备能力(PlaywrightCrawler)”。它原生封装了队列去重、失败自愈重试、代理池轮询和会话保活(SessionPool),开箱即具备商业级鲁棒性。
- Browser-Use:面向 AI Agent 的交互接管库。它通过将浏览器视口渲染为视觉画面或可交互 Accessibility Tree,由大模型自主决策“点击哪个按钮”、“输入什么文字”,非常适合应对需要多步表单填写和登录验证的高难度场景。
3. 经典工业级吞吐阵营(Scrapy / Colly)
如果你面对的是千亿级规模的纯 HTML 页面(如电商海量目录、博客资讯站),并且追求极低的内存消耗与极高的并发处理速度:
- Scrapy:诞生十余年依然坚挺的 Python 工业标准。凭借成熟的 Twisted 异步网络引擎、完备的中间件(Middleware)机制以及丰富的生态扩展(如 Scrapy-Redis),能够轻松支撑分布式集群每天数千万级的数据吞吐。
- Colly:用 Go 语言编写的极速轻量爬虫框架。单个协程极低内存开销,开箱即支持上千并发请求,适合将采集逻辑编译为单独的二进制可执行文件打包部署。
4. 零代码与可视化 RPA 阵营(EasySpider / WebRPA)
对于没有深厚编程背景的业务人员,或者临时需要一次性导出表格数据:
- EasySpider (易爬):基于可视化流程图设计,打开网页后通过鼠标点击选择目标元素,自动生成字段提取规则与翻页循环,支持在本地电脑跨平台独立运行,并可将设计好的任务导出为命令行脚本交给定时任务执行。
四、 实战演练:从原始 HTML 到 LLM-Ready 提纯管线
为了直观展现现代数据采集中的“去噪与格式化清洗”,我们在配套的实战代码中编写了一个确定性的提纯流水线。该脚本模拟了网络请求获取的复杂富文本,并演示了如何剥离无关噪音,产出适合 RAG 知识库的模型就绪 Markdown:
核心提纯脚本 (practice/scraping_demo.py)
import re
import json
from dataclasses import dataclass, asdict
from typing import List

@dataclass
class ScrapedItem:
    tool_name: str
    description: str
    highlights: List[str]

class ModernScraperPipeline:
    def __init__(self, raw_html: str):
        self.raw_html = raw_html

    def clean_noise(self) -> str:
        """剥离广告、导航、脚本、页脚等干扰标签"""
        text = re.sub(r'<script.*?</script>', '', self.raw_html, flags=re.DOTALL | re.IGNORECASE)
        text = re.sub(r'<style.*?</style>', '', text, flags=re.DOTALL | re.IGNORECASE)
        text = re.sub(r'<nav.*?</nav>', '', text, flags=re.DOTALL | re.IGNORECASE)
        text = re.sub(r'<footer.*?</footer>', '', text, flags=re.DOTALL | re.IGNORECASE)
        text = re.sub(r'<div class="ad".*?</div>', '', text, flags=re.DOTALL | re.IGNORECASE)
        return text

    def extract_structured(self) -> List[ScrapedItem]:
        """按卡片维度抽取出核心语义单元"""
        items = []
        pattern = r'<section class="tool-card".*?<h2>(.*?)</h2>\s*<p>(.*?)</p>\s*<ul>(.*?)</ul>'
        matches = re.findall(pattern, self.raw_html, flags=re.DOTALL)
        for name, desc, list_content in matches:
            points = re.findall(r'<li>(.*?)</li>', list_content)
            items.append(ScrapedItem(
                tool_name=name.strip(),
                description=desc.strip(),
                highlights=[p.strip() for p in points]
            ))
        return items

    def to_llm_markdown(self, items: List[ScrapedItem]) -> str:
        """输出契合 LLM 阅读与向量化分块的高质量 Markdown"""
        lines = ["# 结构化采集成果 (LLM-Ready Markdown)\n"]
        for item in items:
            lines.append(f"### {item.tool_name}")
            lines.append(f"**核心简介**:{item.description}")
            lines.append("**特性要点**:")
            for h in item.highlights:
                lines.append(f"- {h}")
            lines.append("")
        return "\n".join(lines)
控制台执行输出 (Stdout 存证)
运行实战脚本后,控制台清晰呈现了从原始含噪 HTML 到结构化提纯全过程:
[1] 启动现代数据采集处理流水线...
[2] 噪声剔除完成,净化前字符数: 1388 -> 净化后: 1127
[3] 成功抽取结构化数据项: 2 条

--- JSON 结构化预览 ---
[
  {
    "tool_name": "1. Crawl4AI (GitHub 40k+ Stars)",
    "description": "专为大模型 RAG 打造的极速开源爬虫引擎,原生支持 Markdown/JSON 转换与选择器自愈。",
    "highlights": [
      "核心优势:速度提升 5 倍,支持智能去除噪音与广告",
      "适用场景:企业级知识库、AI Agent 自主数据获取"
    ]
  },
  {
    "tool_name": "2. Playwright (Microsoft)",
    "description": "新一代无头浏览器自动化统治级工具,支持 Chromium/Firefox/WebKit 全引擎。",
    "highlights": [
      "核心优势:异步事件驱动、强交互动态页面渲染、自动等待",
      "适用场景:复杂 SPA 应用、需滑动验证码与登录态维持"
    ]
  }
]

--- LLM-Ready Markdown 成果 ---
# 结构化采集成果 (LLM-Ready Markdown)

### 1. Crawl4AI (GitHub 40k+ Stars)
**核心简介**:专为大模型 RAG 打造的极速开源爬虫引擎,原生支持 Markdown/JSON 转换与选择器自愈。
**特性要点**:
- 核心优势:速度提升 5 倍,支持智能去除噪音与广告
- 适用场景:企业级知识库、AI Agent 自主数据获取

### 2. Playwright (Microsoft)
**核心简介**:新一代无头浏览器自动化统治级工具,支持 Chromium/Firefox/WebKit 全引擎。
**特性要点**:
- 核心优势:异步事件驱动、强交互动态页面渲染、自动等待
- 适用场景:复杂 SPA 应用、需滑动验证码与登录态维持
五、 现代反爬排坑指南与边界警告
在生产环境中落地数据采集工程,除了选择合适的框架,还必须防范各类隐形陷阱:
重要边界提示 1. TLS 指纹风控:许多网站(如 Cloudflare WAF)会在建立 TCP/TLS 握手阶段比对 Client Hello 中的 Cipher Suites 和 Extensions。仅修改
User-Agent无法绕过高阶 WAF,需采用如curl_cffi、tls-client或原生真实浏览器内核。 2. 选择器脆弱性与自愈:避免使用长链绝对路径(如/html/body/div[2]/div[1]/...)。在复杂应用中,优先依赖语义属性(data-testid、aria-label)或结合 Crawl4AI 的自适应指纹算法进行锚定。 3. 合规与风控频率:严格遵守目标网站的robots.txt规范与请求并发限制,合理设置退避延时(Backoff jitter),防止因突发流量打崩源站服务而触发法律或合规风险。
六、 总结与选型速查表
总结而言,数据采集工具没有“绝对最好”,只有“场景最匹配”:
1. 如果你在研发基于大模型的知识库或 Agent:毫不犹豫选择 Crawl4AI 或 Firecrawl,它们能直接省去你 80% 的 HTML 数据清洗与向量分块前置工程。
2. 如果你需要逆向抓取高交互、需登录授权或滑块验证的现代 SPA 网页:Playwright 或 Crawlee 配合自动化驱动是最佳组合。
3. 如果你面对亿级规模且目标页面多为静态 HTML 的垂直数据抓取:Scrapy(Python)与 Colly(Go)仍然是高并发低资源消耗的工业首选。
4. 如果你是运营、分析师或非技术背景人员:EasySpider 开箱即用的可视化拖拽能够让你在 10 分钟内完成日常数据收集任务。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





