

浏览器可以扔掉,脚本必须留下:Webwright 终端式自动化入门
浏览器 Agent 现在最常见的形态,是把同一个页面会话当成工作台:模型看一眼截图或 DOM,预测下一次 click / type / scroll,执行后再看,循环直到任务结束。会话一旦关掉,轨迹就散了;明天换个日期、换个出发地,还得从头猜坐标。微软研究院 2026 年 5 月开源的 Webwright(github.com/microsoft/Webwright,MIT)把这件事反过来:浏览器是一次性的环境,工作区里的 Python 脚本才是资产。 模型拿到的是终端,不是「下一步点哪里」的动作菜单;它写 Playwright 代码、开浏览器、看日志和截图、修脚本,最后交出一份可复跑的 final_script.py。
源微信页未能稳定抓取正文,本文按官方仓库 README、项目页 microsoft.github.io/Webwright 与微软研究院博文 Webwright: A Terminal Is All You Need For Web Agents(2026-05-04,作者 Yadong Lu、Lingrui Xu、Chao Huang、Ahmed Awadallah)深度改写。只写授权站点上的工具用法与架构,不涉及绕过验证码、未授权访问或攻击步骤。
一、先分清:它不是 codegen 录屏,而是把浏览器当成可丢弃环境
Playwright 自带的 npx playwright codegen 很好用:你在浏览器里点,Inspector 窗口同步吐定位器和断言。那是人驱动、代码跟随。另一类框架(browser-use、不少 Computer Use 配方)则是模型驱动、动作空间固定:每一步从「点这个索引 / 填这个框」里选一个原语。Webwright 两边都不站。它假设模型已经会写、会修 Python,于是把 harness 收成「终端 + 本地工作区 + 按需截图」。
官方动机写得很直:当模型还弱的时候,精细动作循环能兜底;当模型已经能写循环、抽函数、读 traceback 时,同一套循环反而成了瓶颈——日期选择、表单填充、列表过滤本该是一段程序,却被拆成几十轮「再点一下」。Webwright 的立场是把 Agent 和浏览器拆开:浏览器可以随时拉起、检查、扔掉;持久化的是代码、日志、截图。README 把核心约束说死了:
Webwright 给模型一个终端,让它按需拉起多个浏览器会话、检查页面并完成网页任务。截图和页面状态只在需要时捕获。它强制每个任务最终落进一份可复跑的 Python 脚本——浏览历史就是一个代码文件。没有多智能体编排、没有图引擎、没有插件层。
这和 RPA 工程师的日常很像:先探路、再固化、再参数化。探路阶段可以乱写临时脚本;收工标准不是「页面看起来做完了」,而是换一个干净目录再跑一遍 final_script.py,日志和关键点截图能过自省闸门。对回归测试、运营查询、内部后台的重复填报,这份脚本才是第二天还能用的东西。codegen 录下来的是一次点击序列;Webwright 要的是一份带循环和参数的程序。
选型时先问自己:任务会不会反复跑?字段会不会变?如果答案是「只做一次、页面每天改版」,坐标式 Computer Use 仍有位置——官方也承认低层点击在「结构难抽象」时更通用。Webwright 吃的是另一头:结构稳定、需要复用、愿意把工作流编译成代码的网页任务。
二、三模块小 harness:Runner、模型接口、终端环境
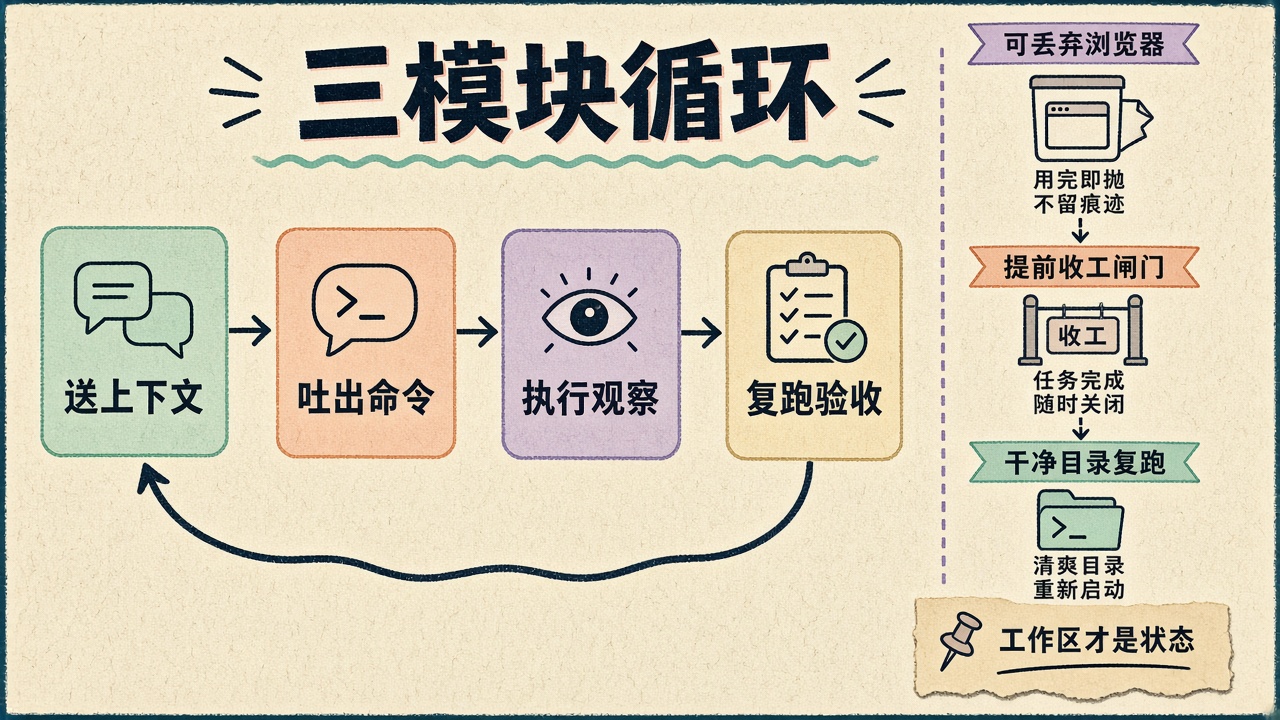
项目页把实现压到大约 1K 行 harness:Runner ~150 行、模型接口 ~550 行、终端 Environment ~300 行。仓库地图更细:核心循环 src/webwright/agents/default.py 约 450 行,Playwright 环境约 570 行,CLI src/webwright/run/cli.py 约 150 行。依赖只有 httpx、pydantic、playwright、typer。没有隐藏的图调度器,也没有「规划 Agent / 执行 Agent / 审核 Agent」三套提示词互相传球。
一次任务就是一条扁循环:

1. Send context:Runner 把任务说明、工作区现状、最近观察送给模型。
2. Emit bash:模型返回思考块 + 一条 shell。常见动作是往工作区写 Playwright 脚本,再 python 跑它。
3. Return observations:环境执行命令,把 stdout、日志、截图、文件、报错塞回上下文。
4. Refine and finish:循环直到产出最终脚本,在新目录复跑,并通过 self-reflection。
开放式 bash 带来两个工程问题,官方没有用更大框架去「罩住」,而是各加一道薄闸。提前收工(premature done):模型可以自己报完成,于是经常「看起来成功」就停。闸门要求:生成最终脚本 → 在干净文件夹复跑并保存日志/截图 → 跑 python -m webwright.tools.self_reflection 得到 success/failure;否则丢掉 done: true 继续修。上下文爆炸:长编码轨迹很快顶满窗口,于是大约每 20 步把历史压成一份摘要,具体产物仍躺在磁盘上。截图不是每步必拍,模型自己决定何时 image_qa——这和「每步都喂全页像素」的视觉 Agent 成本结构完全不同。
python final_script.py
python -m webwright.tools.self_reflection
ls final_runs/run_1
# final_script.py  final_script_log.txt  screenshots/  self_reflect_result.json
工作区才是状态机。浏览器进程挂了,脚本还在;换一台机器,只要 Chromium 和依赖齐,同一份 final_script.py 仍能复现路径。这比把 Cookie 和页内状态藏在守护进程里更适合做「可审查的自动化」。
三、和其他浏览器 Agent 仓库差在哪:动作空间与「什么算状态」
选型时别只看 Star。Stagehand、Vercel agent-browser、browser-use、Webwright 解决的是相邻但不同的接口问题。官方对比表把分水岭画在范式、动作空间、状态落在哪、循环长什么样:
| 维度 | Stagehand | agent-browser | browser-use | Webwright |
|---|---|---|---|---|
| 范式 | 代码 + 自然语言原语(act / extract / agent) |
给另一个编码 Agent 调的 CLI | 在 DOM/AX 快照上自主循环 | 带终端的编码 Agent,浏览器只是它拉起的环境 |
| 动作空间 | Playwright,或 NL 译成 Playwright | 离散子命令(open、click @e2、snapshot) |
模型选索引后的 click/type | 自由 Python,自己写 Playwright 脚本 |
| 状态是什么 | 浏览器会话 | 守护进程里的会话 | 浏览器会话 | 本地工作区:代码、截图、日志;浏览器可丢 |
| 循环形状 | 命令式;需要时 agent() 多步 |
一次 CLI 一次微步骤 | observe → 下一步 → 执行 | 写代码 → 执行 → 看截图 → 修脚本 |
读这张表时,真正要拍板的是「失败了你想看什么」。会话型框架失败时,现场在浏览器里:当前 URL、高亮节点、未提交表单。Webwright 失败时,现场在磁盘上:哪一段 page.locator 超时、哪张关键点截图对不上、traceback 指向哪一行。后者更像调试普通 Python 服务。代价是:模型必须会写选择器、会 wait_for、会处理懒加载;它不会替你把「点第三个蓝按钮」翻译成稳定 API——那是 Stagehand act() 更擅长的层。
另一条分界是一步能走多远。坐标 / 索引式 Agent 一步通常只做一次点击;Webwright 一步可以是「打开列表、翻三页、抽出价格、写成 CSV」。官方强调 code-as-action 在长程任务上更省轮次、更少误差累积。代价同样清楚:脚本一旦写死某站点的 DOM,站点改版就要回归。所以仓库后补了 Skill Factory:技能入库前要能无模型重放自己的答案,避免一条坏脚本污染库。
如果你的团队已经有 Claude Code / Codex,还要不要再上一套「浏览器 MCP」?Webwright 的回答是:不必再包一层工具 schema,把同一份 skills/webwright/ 接到宿主即可。宿主自己读 PNG 的话,连 image_qa / self_reflection 都可以跳过。这是「终端原生」而不是「再发明一套浏览器协议」。
四、本地 CLI:从安装到一次可复跑任务
环境要求很短:Python 3.10+、用 Playwright 装好 Chromium、再准备所选后端的 API Key(OpenAI / Anthropic / OpenRouter)。image_qa 和 self_reflection 默认跟配置里的同一个模型走,Anthropic 跑通不必再配一份 OpenAI Key。
git clone https://github.com/microsoft/Webwright.git
cd Webwright
pip install -e .
playwright install chromium

export OPENAI_API_KEY="sk-your-api-key-here"

python -m webwright.run.cli \
    -c base.yaml -c model_openai.yaml \
    -t "Search for flights from SEA to JFK on 2026-08-15 to 2026-08-20" \
    --start-url https://www.google.com/flights \
    --task-id demo_openai \
    -o outputs/default
关键开关:
| Flag | 含义 |
|---|---|
-c |
叠配置。src/webwright/config/ 下的 yaml 可多份叠加 |
-t |
任务自然语言 |
--start-url |
起始页 |
--task-id |
输出子目录名 |
-o |
产物根目录 |
Claude 后端把 model_openai.yaml 换成 model_claude.yaml,并导出 ANTHROPIC_API_KEY。配置可叠加:例如再加 -c task_showcase.yaml,运行结束会多写出 task.json + report.json,给仓库自带的小 Flask 看板渲染。纯 base.yaml 只产 trajectory.json 和调试产物,没有 report.json。
pip install flask
python assets/task_showcase/app.py    # http://127.0.0.1:5005

python -m webwright.run.cli \
    -c base.yaml -c model_openai.yaml -c task_showcase.yaml \
    -t "<repeatable web task>" \
    --task-id my_repeatable_task \
    -o outputs/default

python assets/task_showcase/app.py \
    --tasks-dir outputs/default/<run>/task_showcase/tasks
Task Showcase 面向可重复的 odyssey 类任务(比价、库存、列表、招聘板、天气):每个任务目录只放元数据和结构化报告,模板通用,加新任务就是丢一个新文件夹。这和「每次让模型重新点一遍」是反着来的——看板消费的是已经编译好的结果,不是现场会话。
配套练习目录里放了一份教学用的参数化 Playwright 草稿(practice/final_script_demo.py),演示 /webwright:craft 一类产物长什么样:具体任务值变成 argparse 默认值,下次只改 --origin。它只访问公开示例页,用来理解「浏览历史 = 一份代码」,不是生产爬虫。
五、接到 Claude Code、Codex、OpenClaw:同一份 skill,宿主驱动循环
2026-05-06 起,仓库带 Claude Code 与 Codex 的 plugin manifest,技能目录是共用的 skills/webwright/。宿主用自己的订阅驱动循环,不必再单独买一份「浏览器 Agent API」。公共依赖仍是:
pip install -e .
playwright install chromium
Claude Code 把本仓库加成 marketplace 再装插件,然后新开会话(插件在会话启动时加载):
/plugin marketplace add microsoft/Webwright
/plugin install webwright@webwright

/webwright:run search Google Flights for flights from SEA to JFK on 2026-08-15 to 2026-08-20
/webwright:craft search a ticket on Google Flights from LAX to SFO depart June 7 return June 14
/webwright:run 产出一次性 final_script.py,字面值写死。/webwright:craft 把同一段流程收成带 Google 风格 Args: 文档字符串的函数,外加 argparse;默认值是这次任务的具体参数,下次可以:
python final_script.py --origin JFK --destination LAX --depart-date 2026-07-01
两种模式都会在工作区写 plan.md,把带埋点的 Playwright 脚本放到 final_runs/run_*/,并用保存的关键点截图做视觉自检。
Codex 能读 Claude 风格 marketplace:
codex plugin marketplace add microsoft/Webwright
codex
/plugins
新线程里用自然语言,或显式 @webwright ...。关掉插件不必卸载,把 ~/.codex/config.toml 里对应项设 enabled = false 再重启即可。
OpenClaw 从本地 checkout 安装后重启 gateway:
openclaw plugins install /absolute/path/to/Webwright
openclaw gateway restart
openclaw plugins list | grep webwright
openclaw skills  list | grep webwright
卸载:openclaw plugins uninstall webwright。Hermes Agent 兼容 agentskills.io,把 skills/webwright 软链到 ~/.hermes/skills/webwright 即可;/webwright:run 这类子命令是 Claude/Codex 约定,在 Hermes 里无效,但 SKILL.md 仍会端到端工作。
插件路径的意义是:编码 Agent 已经会用终端,Webwright 不必再发明一套 MCP 工具列表。仓库给过一次轨迹对比:同一条「找符合条件的二手车」任务,本地 harness 总 token 约 42 万,Codex skill 变体约 329 万——数字会随运行波动,但方向清楚:把浏览器微步骤塞进通用编码 Agent 的工具层,上下文税可以非常高。若你关心成本,先跑本地 CLI,再决定要不要把 skill 挂进日常 IDE。
六、Skill Factory:解过一次,就变成可复跑、可组合的代码技能
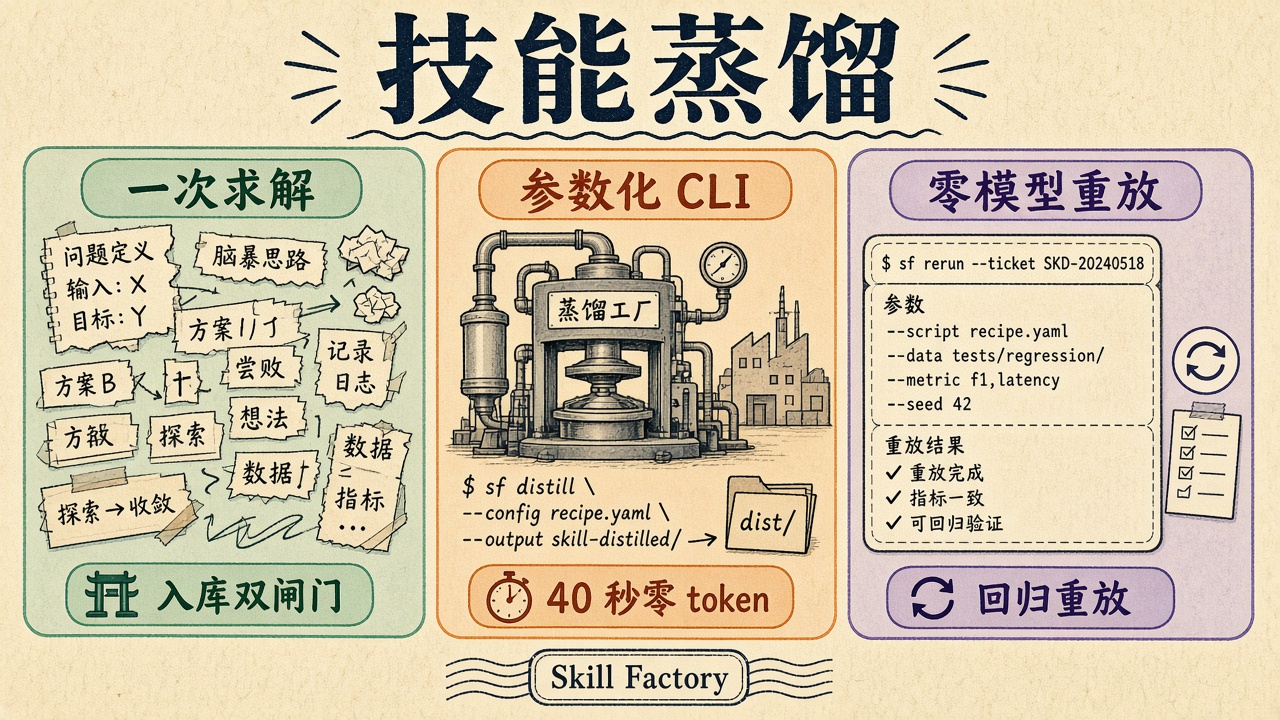
2026-07-21 的 Skill Factory 把「脚本资产」推进一步。官方原话是:多数 Agent skill 是模型要读的上下文;他们的 skill 是程序。webwright.skill_factory 把每次成功求解留下的脚本,蒸馏成可参数化、经验证、能独立跑的技能库——不改 Agent 主循环。
复用发生在循环之外:开跑前 recommend 查库,route 给出 {verdict: run|adapt|skip, skill_id, source_path}——能直接跑就零模型执行,不能就当先验塞进提示词。增长发生在循环之后:
python -m webwright.skill_factory learn outputs/ --library ./library
build 是 solve→learn 一条龙;update 是手写 manifest。入库有两道门:错误求解不能进蒸馏;蒸馏出的技能必须无模型重放自己的答案。新求解会原地拓宽技能,并回归重放旧覆盖,避免「越学越坏」。官方数字:技能独立跑大约 40 秒、零 token;WebArena 上一组 retrieve 模板(10 个模板、3 个自建站、gpt-5.4)复用把 held-out 准确率从 55% 提到 70%(+15 pp),同时减少步数。
这解决的是 RPA 真正的成本结构:第一次探索可以贵(GPT-5.4 在 Online-Mind2Web 上大约 $2.37 / 任务),第二次应该便宜到「跑脚本」。粒度仍然是难题:太细会碎成几千条微程序,太粗又绑死第一次的字面任务。/webwright:craft 的 argparse 包装是人工侧的同一思想——先用具体值跑通,再把出发地、日期抬成参数。维护责任也一并留下:站点改版后要重新验证,静默失败比「模型这次没点到」更难发现。官方建议把脚本索引做成带校验、能退役的库,而不是把所有 .py 当永久真理。
七、基准怎么读:长程分数、小模型工具、以及它不会替你做的事
项目页和博文给了两套真实站点基准(100 步预算)。Online-Mind2Web(300 题、136 个站点):GPT-5.4 86.7%,开源 harness 的 AutoEval 类别里当时最高;Claude Opus 4.7 84.7%,困难集更强(N=100 时 80.5% vs 76.6%)。对照同一 GPT-5.4 的截图+xy 坐标基线,Webwright 在易/中/难三档都拉开差距——这是「代码动作」对「猜像素」的直接比较,不是换了更强模型。Odysseys(200 道长程、指令平均 272 词):GPT-5.4 + Webwright 60.1%(平均 76.1 步),相对先前视觉+持久会话 SOTA(Opus 4.6,44.5%)大约 +15.6 分,相对基线 GPT-5.4 坐标方案(33.5%)大约 +26.6 分。项目页另报 60.8%,引用时以仓库 README 与博文为准即可。
小模型不是陪衬:在「站点已有 5 个以上工具」的困难切分上,Qwen3.5-9B 借助生成好的可复用工具能到 66.2%。含义很工程:先用大模型把流程编译成 CLI,再让小模型选工具执行,比让 9B 自己从像素里搜按钮更划算。成本侧:多数题在 50 步内结束;Opus 平均步数更少(21.9 vs 26.3),但单价更高,Online-Mind2Web 上平均约 $6.09 vs $2.37。前 50 步已经能到约 82% 准确率,后 50 步再换 3~4 个点——加步数有收益,但边际很陡。
边界同样写在论文和 README 里,不要营销式忽略:
- 站点改版:选择器会过期。没有 Skill Factory 的回归重放,脚本库会静默漂。
- 验证闸门会拒收过早的 done:这是特性。若任务其实没做完,你会看到循环继续,而不是一条假成功。
- 授权与合规:只在你有权自动化的后台、文档站、测试环境跑。公开基准是评测集,不是「整网可爬」的许可证。
- 验证码、登录墙、未授权接口:不在本文范围,也不该写进
final_script.py。需要登录时用官方允许的存储状态(Playwrightstorage_state)或测试账号,而不是对抗风控。 - 低层点击仍有必要:结构稀缺、画布应用、一次性探索,坐标/快照式 Agent 更通用。Webwright 自己也说,未来应在「缓存脚本」和「感知原语」之间切换,而不是宣称代码能覆盖一切。
2026-05-11 的 Task2UI 把结果渲染成可打开的 HTML 小应用,和 Task Showcase 一样,强调产物可看、可复用,而不是把成功定义成「Agent 说完成了」。调试时优先打开 final_runs/、trajectory.json 和关键点截图,而不是盯着模型口头总结。
想自己对照原文,从仓库 github.com/microsoft/Webwright 的 README 和配置目录入手,项目页 microsoft.github.io/Webwright 看循环演示,博文 Webwright: A Terminal Is All You Need For Web Agents 看基准表。循环形状借鉴 SWE-agent / mini-swe-agent,浏览器层就是 Playwright。配套练习草稿在 practice/final_script_demo.py,只用来理解参数化脚本的形状。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





